Phase 2 · รถ EV
ชุดข้อมูลรถ EV และผลทดสอบล่าสุด
หน้านี้คือ ผลตามจริง ของระบบบนภาพรถ EV ทั้ง 1,811 ภาพ — จุดเริ่มต้น (baseline) ของโมเดลปัจจุบัน และผลเทสล่าสุดจากการทดลองเทรนใหม่แบบเร็ว เทียบกับชื่อโฟลเดอร์ที่เจ้าหน้าที่จัดไว้ ส่วนหน้า Live Monitor แสดงเฉพาะภาพตัวอย่างที่คัดมาสาธิตการทำงาน · Honest results on the EV-van set: current-model baseline plus the latest quick-retrain experiment.
จุดเริ่มต้น — โมเดลปัจจุบัน ก่อนเทรนใหม่ · ทั้ง 1,811 ภาพ
26.1%
ทายตรงระดับ (เทียบชื่อโฟลเดอร์)
ระดับละ 20% รวม 6 ระดับ · ไม่สุ่ม ไม่ตัดไฟล์ใด
62.4%
คลาดเคลื่อนไม่เกิน 1 ระดับ
นับรวมภาพที่ทายตรงและภาพที่พลาดไประดับข้างเคียง
24.9 จุด
คลาดเคลื่อนเฉลี่ย (MAE โดยประมาณ)
เป้าหมาย ≤ 10 จุด · ค่าคาดหวังถ่วงน้ำหนักด้วยความน่าจะเป็น 24.6 จุด
19.7%
อยู่ภายใน ±10 จุด (ประมาณ)
เป้าหมาย ≥ 85% · จากค่าคาดหวังถ่วงน้ำหนัก (ถ้านับจากระดับที่ตอบ = 26.1% เท่ากับทายตรงระดับ)
ผลเทสล่าสุด — ทดลองเทรนส่วนหัว (ขั้นที่ 3) · ก่อน → หลัง บนภาพชุดเดียวกัน
30.9% → 61.0%
ทายตรงระดับ · ชุดทดสอบ time-block
n=382 · คาดไว้ก่อนทดลอง 55–80% · เซสชันเดียวกับที่เทรน
22.2 → 9.5 จุด
MAE (โดยประมาณ) · ชุดทดสอบ time-block
เป้าหมาย ≤ 10 จุด · คาดไว้ก่อนทดลอง 6–12 จุด
38.0% → 39.2%
ข้ามเซสชัน · recall ของ 41–60%
n=79 ระดับเดียว · ยังไม่เห็นการเปลี่ยนแปลงที่วัดได้
→
ดูรายละเอียดการทดลอง →
วิธีแบ่งข้อมูล เช็กทางลัด ช่วงที่คาดไว้ และตารางความสับสนก่อน/หลัง (หัวข้อ 4)
ชุดข้อมูลรถ EV คืออะไร
What the EV dataset is
ชุดตัวอย่างจากรถตู้ไฟฟ้าของไปรษณีย์ไทย ถ่ายจากกล้องมุมกว้างตัวเดียวในห้องสินค้า เป็นภาพสี มีเวลาพิมพ์บนภาพ เจ้าหน้าที่จัดภาพลงโฟลเดอร์ตามระดับพื้นที่ว่าง (ระดับละ 20%) ซึ่งใช้เป็น “คำตอบอ้างอิง” ของทุกตัวเลขในหน้านี้
โฟลเดอร์ (ระดับพื้นที่ว่าง)
0_ · 1-20_ · 21-40_ · 41-60_ · 61-80_ · 81-100_
โครงสร้าง
flat — 1 โฟลเดอร์ต่อ 1 ระดับ
จำนวนภาพ
1,811 ภาพ
ขนาดภาพ
640x360
วันที่ถ่าย (กล้อง)
05/08, 06/08
ไฟล์ซ้ำ
12 ไฟล์
ภาพจับหน้าจอ
36 ภาพ
ยานพาหนะ / กล้อง
รถตู้ไฟฟ้า (EV van) · กล้อง 1 ตัว มุมกว้าง ภาพสี
โมเดลปัจจุบันเทรนจากรถอีกแบบ (รถบรรทุก ภาพอินฟราเรด) และไม่เคยเห็นภาพรถ EV มาก่อน
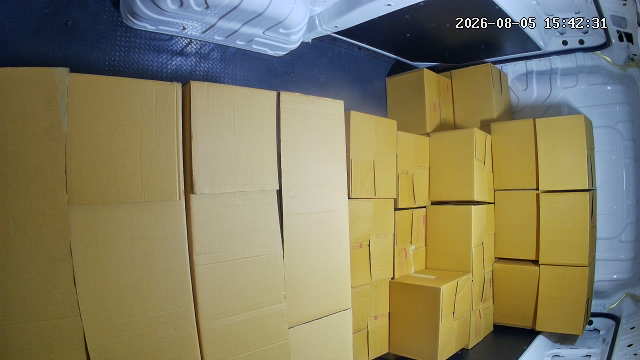
ตัวอย่าง 2 ภาพต่อระดับ (เลือกกระจายตามเวลาถ่าย) พร้อมช่วงเวลาที่ถ่ายของแต่ละโฟลเดอร์ — ป้าย ถูก/ผิด คือผลของโมเดลปัจจุบันบนภาพนั้น
n = 300
 ถูก
ความมั่นใจ 78%
 ถูก
ความมั่นใจ 64%
n = 311
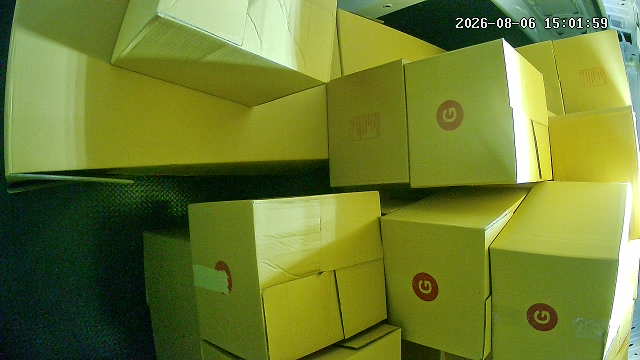 ผิด
ความมั่นใจ 78%
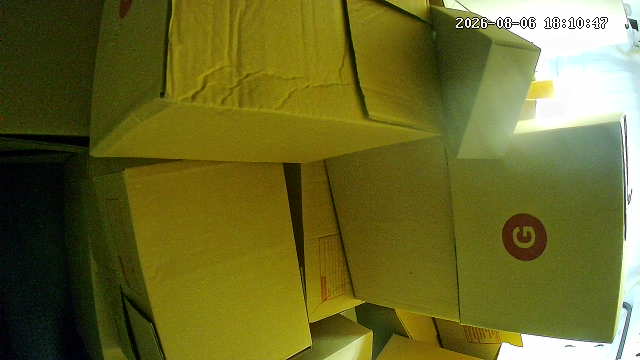 ผิด
ความมั่นใจ 47%
n = 300
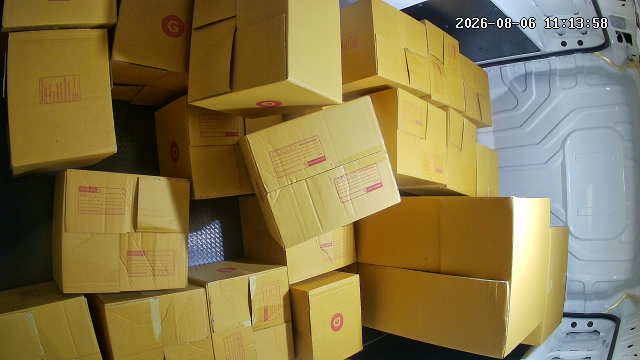 ผิด
ความมั่นใจ 42%
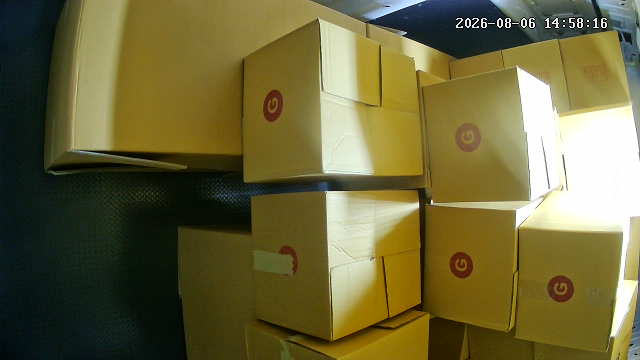 ผิด
ความมั่นใจ 62%
n = 300
ถูกความมั่นใจ 82%
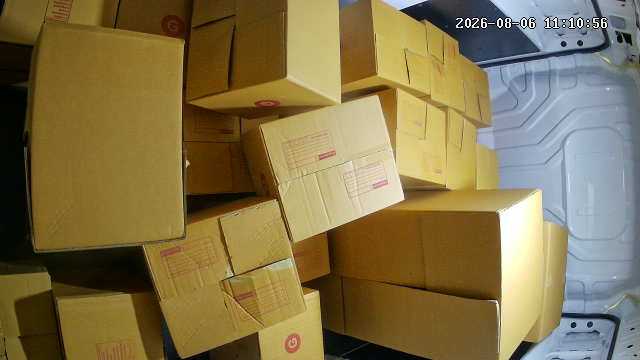 ถูก
ความมั่นใจ 56%
n = 300
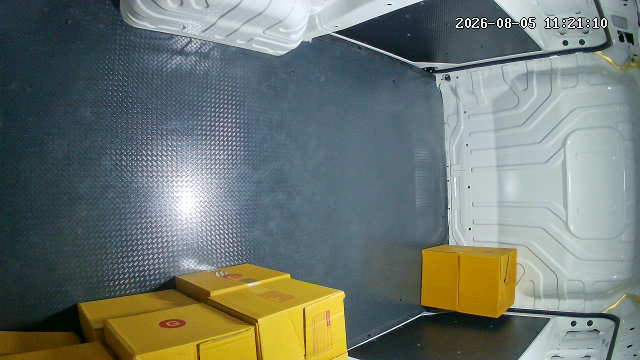 ถูก
ความมั่นใจ 65%
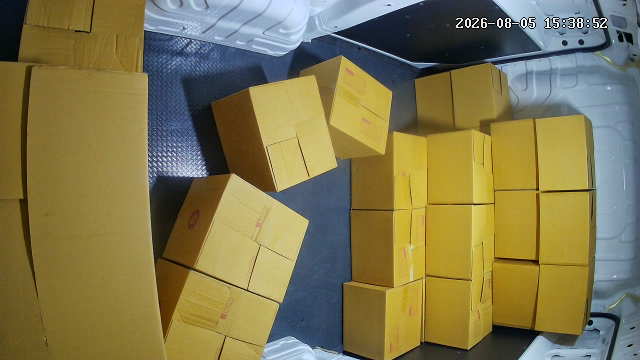 ผิด
ความมั่นใจ 83%
n = 300
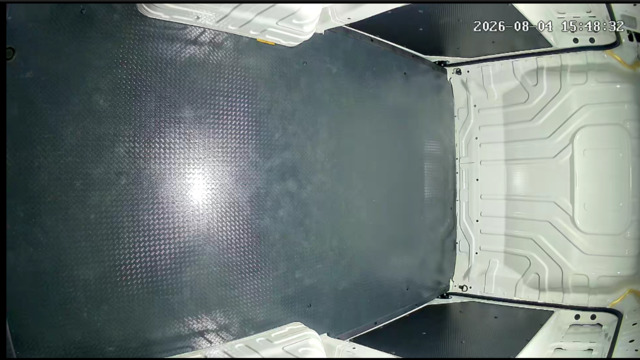 ถูก
ความมั่นใจ 80%
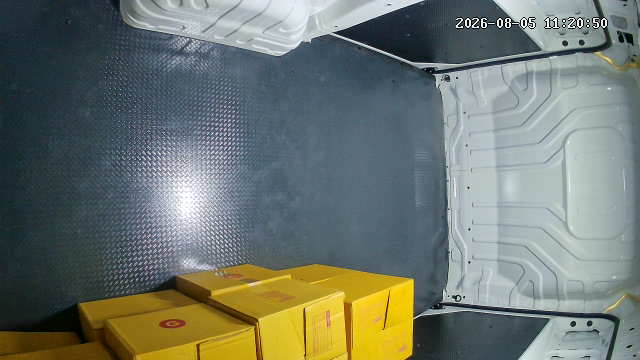 ผิด
ความมั่นใจ 50%
ถ่ายเมื่อไร — 1 ระดับ = 1 ช่วงเวลา
Capture sessions
อ่านเวลาจากชื่อไฟล์และเวลาที่พิมพ์บนภาพ พบว่าภาพของแต่ละระดับถูกถ่ายต่อเนื่องในช่วงเวลาเดียว ระหว่างวันที่ 05/08 และ 06/08 (ส่วนภาพจับหน้าจอ 36 ภาพ ถ่ายต่างหากอีกวัน)
แต่ละระดับถูกถ่ายในช่วงเวลาเดียวกันเกือบทั้งหมด (1 ระดับ ≈ 1 รอบการโหลดของ) ทำให้แสง โทนสี และเวลาที่พิมพ์อยู่บนภาพ ผูกติดกับระดับพื้นที่ว่างโดยไม่ตั้งใจ — หากแบ่งชุดฝึก/ทดสอบแบบสุ่มจากชุดนี้ ภาพเฟรมติดกันจะไปอยู่ทั้งสองฝั่ง และค่าความแม่นยำที่วัดได้จะสูงเกินจริง · แถบลายเฉียงเส้นประ = ภาพจับหน้าจอ (screenshot) ไม่ใช่เฟรมจากกล้องโดยตรง
ความอิ่มตัวของสีเฉลี่ยต่อระดับ (mean saturation, 0–255) — ยิ่งมีกล่องเหลืองมาก สียิ่งจัด
ค่าความอิ่มตัวลดลงตามระดับความว่างอย่างเป็นระบบ — โมเดลที่เทรนบนชุดนี้ตรง ๆ อาจ “เดา” จากความเหลืองของภาพ หรือแสงในช่วงเวลานั้น แทนการดูพื้นที่ว่างจริง จึงต้องออกแบบการเก็บภาพและการแบ่งข้อมูลให้ตัดทางลัดนี้ (ดูแผนพัฒนา)
ผลโมเดลปัจจุบัน เทียบกับชื่อโฟลเดอร์
Current model vs folder label
นับว่า ถูก เมื่อระดับที่ AI ตอบตรงกับโฟลเดอร์ที่เจ้าหน้าที่จัดไว้ (ทั้ง 1,811 ภาพ ไม่สุ่ม ไม่ตัดไฟล์ใด) — ทายตรง 26.1% · คลาดเคลื่อนไม่เกิน 1 ระดับ 62.4% · Macro F1 0.259
Confusion Matrix
แถว = โฟลเดอร์จริง · คอลัมน์ = ระดับที่ AI ทำนาย · แนวทแยง (เขียว) คือทายถูก · สังเกตคอลัมน์ 41-60 ที่หนาแน่น
ความแม่นยำรายคลาส
Recall ต่อคลาส (สัดส่วนภาพที่ทายถูกในคลาสนั้น)
โมเดลตอบ “กลาง ๆ” เมื่อไม่แน่ใจ (prediction collapse)
เทียบสัดส่วนภาพในแต่ละระดับตามชื่อโฟลเดอร์ กับสัดส่วนคำตอบที่ AI ให้ (นับจากคอลัมน์ของ confusion matrix)
คลาสจริง (ตามโฟลเดอร์)
ที่ AI ทาย
ค่าความมั่นใจของโมเดล แยกถูก/ผิดได้หรือไม่
ถ้าความมั่นใจใช้ได้ ภาพที่ทายถูกควรมีค่าสูงกว่าภาพที่ทายผิดอย่างชัดเจน และการตั้งเกณฑ์ควรทำให้ความแม่นยำสูงขึ้น
ความมั่นใจเฉลี่ย · ภาพที่ทายถูก
65.1%
ความมั่นใจเฉลี่ย · ภาพที่ทายผิด
63.4%
| ตอบเฉพาะเมื่อมั่นใจ ≥ | ครอบคลุมภาพ | ความแม่นยำในส่วนนั้น |
|---|---|---|
| 50% | 76.4% | 27.2% |
| 60% | 60.4% | 27.3% |
| 70% | 43.5% | 27.8% |
| 80% | 18.9% | 26.6% |
สรุป: โมเดลปัจจุบัน “ไม่รู้ว่าตัวเองไม่รู้” — ใช้ค่าความมั่นใจคัดกรองไม่ได้ (65.1% เทียบ 63.4%แทบไม่ต่างกัน) การปรับเทียบความมั่นใจจึงเป็นหนึ่งในขั้นตอนของแผนพัฒนา
ถ้ารวมผล 2 กล้อง (Late Fusion) จะช่วยไหม — จำลองจากข้อมูลที่มี
ชุดข้อมูลรถ EV มีกล้องเดียว จึงใช้ภาพ 2–5 เฟรมติดกันของการจัดของครั้งเดียวกันแทน “สองมุมมอง” แล้วรวมผลด้วยวิธีเดียวกับหน้า Live Monitor (เฉลี่ยความน่าจะเป็น 6 ระดับ แล้วเลือกระดับที่สูงสุด) · นับเฉพาะภาพจากกล้องที่มีเวลาถ่าย (n=1,775 ไม่รวมภาพจับหน้าจอ) แถวแรกจึงต่างจาก KPI ด้านบนเล็กน้อย
| วิธีรวมผล | เฟรม/ครั้ง | n | ทายตรงระดับ | ±1 ระดับ | MAE (โดยประมาณ) | ตอบ 41-60% มากสุด |
|---|---|---|---|---|---|---|
| ภาพเดียว (วิธีปัจจุบัน) | 1 | 1,775 | 25.7% | 62.2% | 24.9 จุด | 43.9% |
| เฉลี่ยความน่าจะเป็น (แบบหน้า Live Monitor) | 2 | 887 | 25.4% | 61.6% | 25.0 จุด | 45.8% |
| เฉลี่ยความน่าจะเป็น (แบบหน้า Live Monitor) | 3 | 591 | 26.4% | 61.6% | 24.9 จุด | 46.0% |
| เฉลี่ยความน่าจะเป็น (แบบหน้า Live Monitor) | 5 | 354 | 26.3% | 59.6% | 25.7 จุด | 47.5% |
| เลือกภาพที่มั่นใจกว่า | 2 | 887 | 26.8% | 63.5% | 24.2 จุด | 46.6% |
สรุป: รวมกี่มุมก็ได้ผลใกล้เดิม (ต่างจากภาพเดียวไม่เกิน 1.1 จุด) เพราะการเฉลี่ยตัดได้เฉพาะ “สัญญาณรบกวน” แต่โมเดลปัจจุบันผิดแบบ “เอียงไปทางเดียว” (ยุบไปตอบ 41-60%) ทั้งสองมุมจึงผิดไปทางเดียวกัน · รถ EV ในระยะที่ 2 จะมีกล้อง 2 ตัวจริง (644 กล้อง / 322 คัน) การรวมผลจึงยังอยู่ในแผน แต่คาดว่าจะช่วยได้ก็ต่อเมื่อเทรนโมเดลใหม่ก่อน (ขั้นที่ 8 ของแผนพัฒนา)
ตัวอย่างการทำนาย
ภาพจริงจากรถ EV พร้อมโฟลเดอร์จริงเทียบกับที่ AI ทำนาย (โมเดลปัจจุบัน ก่อนเทรนใหม่)
✓ ทายถูก
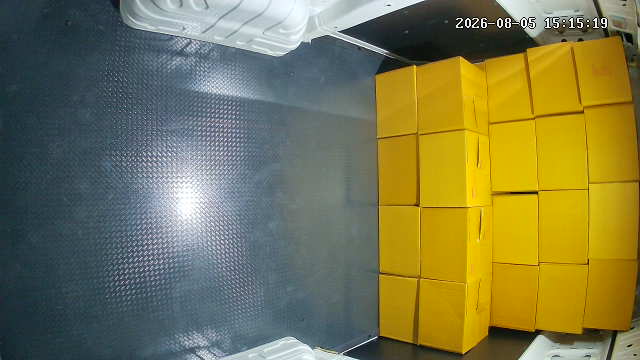 ถูก
ความมั่นใจ 84%
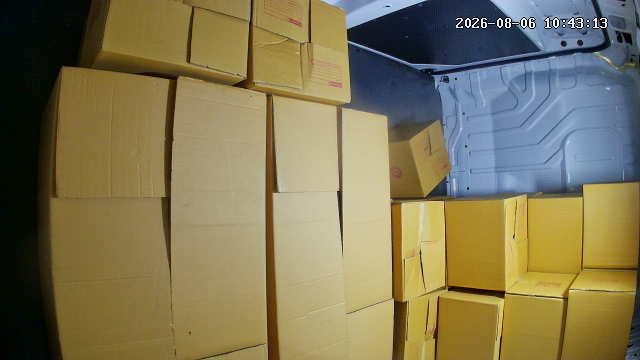 ถูก
ความมั่นใจ 83%
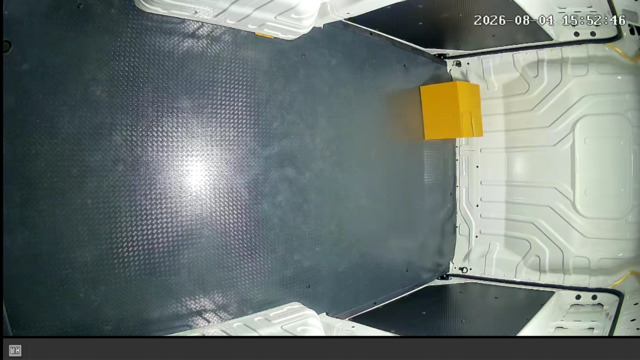 ถูก
ความมั่นใจ 80%
 ถูก
ความมั่นใจ 80%
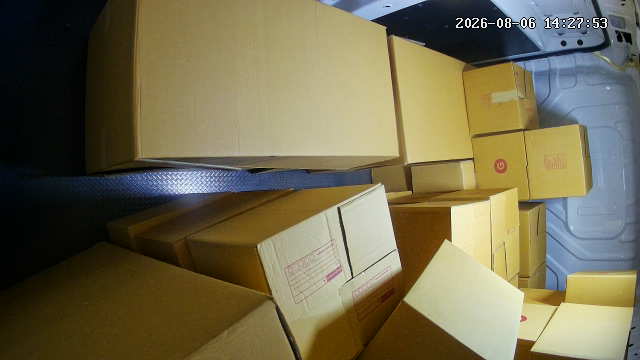 ถูก
ความมั่นใจ 78%
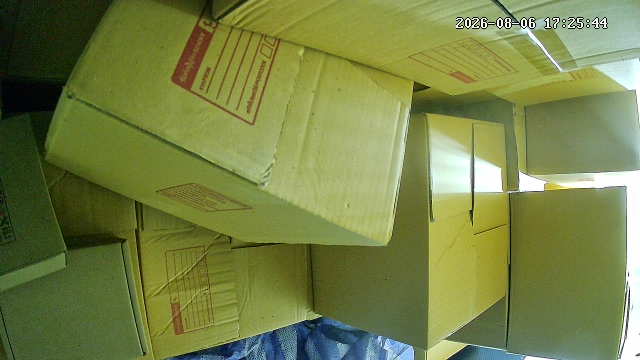 ถูก
ความมั่นใจ 54%
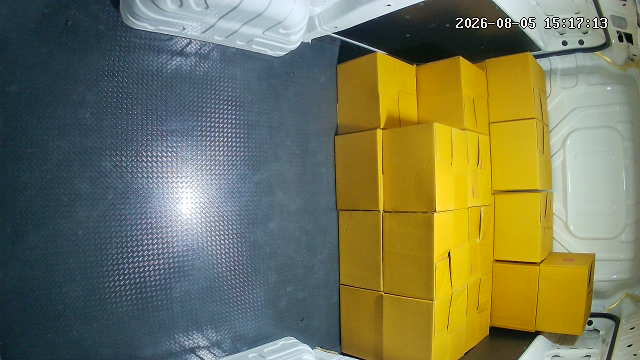 ถูก
ความมั่นใจ 83%
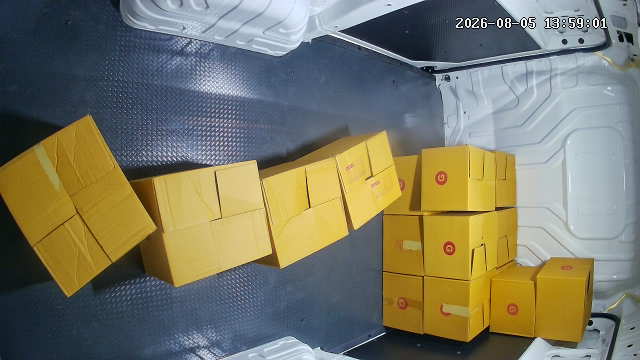 ถูก
ความมั่นใจ 83%
✗ ทายผิด — ส่วนใหญ่ถูกดึงไปตอบ 41–60% ไม่ว่าคลาสจริงจะเป็นอะไร
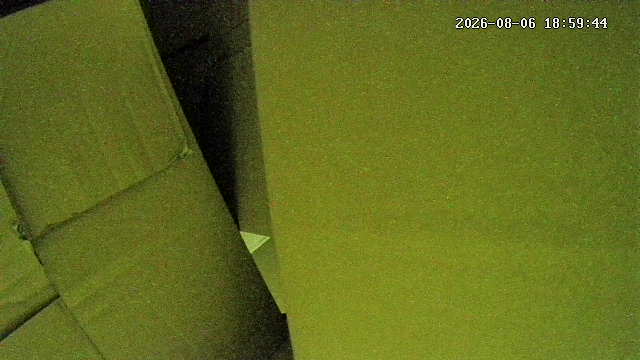 ผิด
ความมั่นใจ 83%
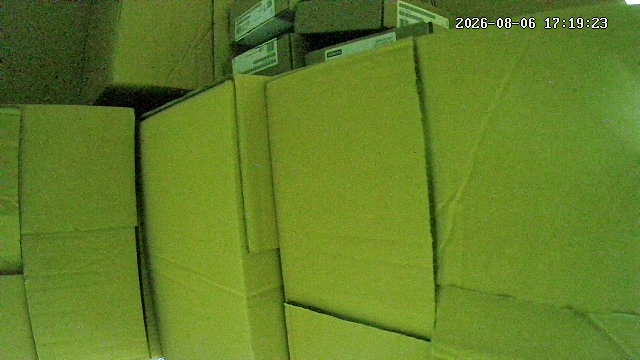 ผิด
ความมั่นใจ 83%
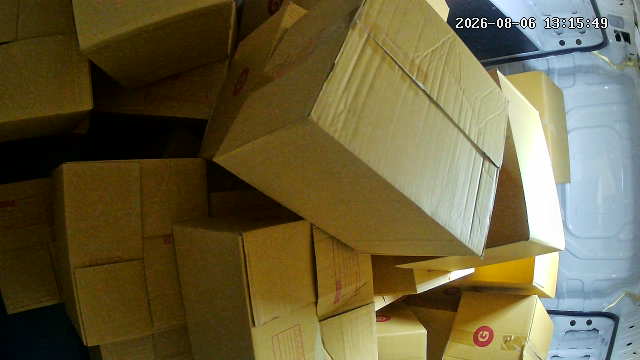 ผิด
ความมั่นใจ 83%
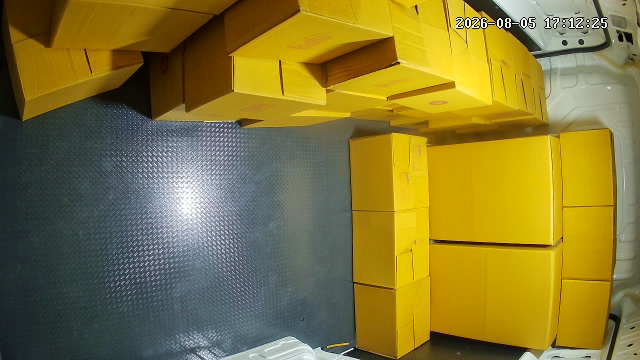 ผิด
ความมั่นใจ 77%
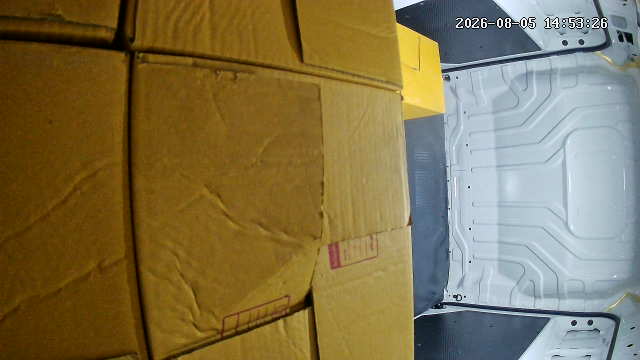 ผิด
ความมั่นใจ 83%
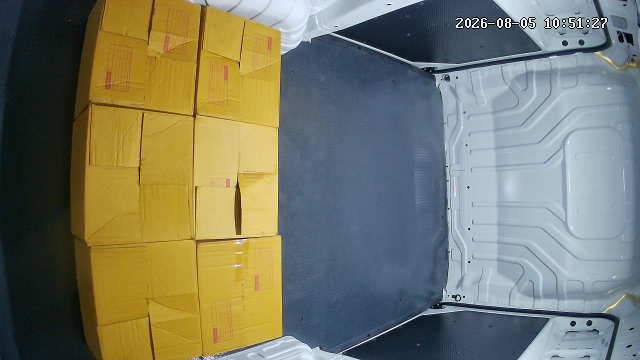 ผิด
ความมั่นใจ 78%
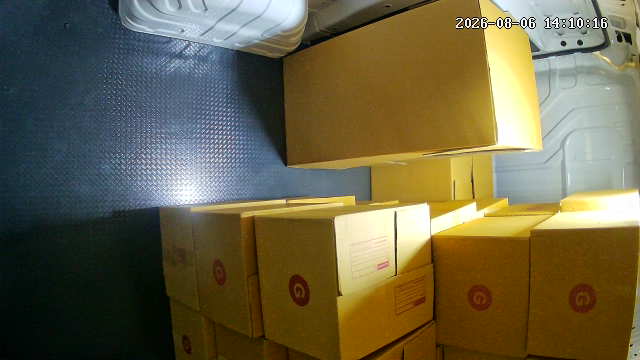 ผิด
ความมั่นใจ 84%
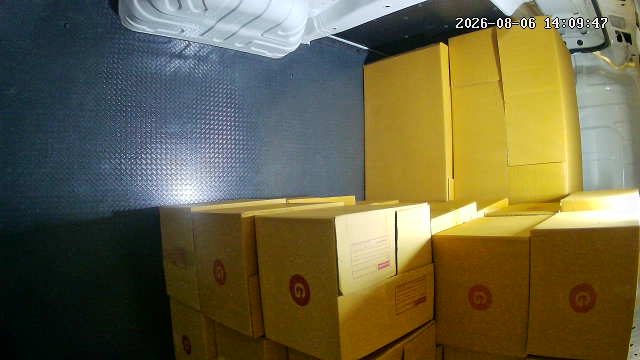 ผิด
ความมั่นใจ 84%
ผลเทสล่าสุด: ทดลองเทรนใหม่แบบเร็ว (ขั้นที่ 3 ของแผน)
Latest test · quick head-only fine-tune
เพื่อดูว่าช่องว่างนี้ปิดได้จริงไหม เราทดลองขั้นแรกของแผนบนโน้ตบุ๊กธรรมดา (CPU): แช่แข็ง backbone ของโมเดลปัจจุบัน แล้วเทรนเฉพาะชั้นจำแนก (2,316 พารามิเตอร์) ด้วยภาพรถ EV แบ่งข้อมูลแบบกันรั่ว (เรียงตามเวลา เว้นช่องว่าง 5 นาทีระหว่างชุด และกันหนึ่งเซสชันไว้ทดสอบข้ามเซสชัน) แล้ววัด “ก่อน/หลัง” บนภาพชุดเดียวกันด้วยเครื่องมือเดียวกับหน้านี้ · Frozen backbone, retrained head, leakage-aware time-block split.
| ชุดทดสอบ time-block (เซสชันเดียวกับที่เทรน วันเดียวกัน) · n=382 | ก่อน (โมเดลปัจจุบัน) | หลังเทรนส่วนหัว | เปลี่ยน |
|---|---|---|---|
| ทายตรงระดับ | 30.9% | 61.0% | ▲ 30.1 จุด |
| คลาดเคลื่อนไม่เกิน 1 ระดับ | 69.4% | 92.2% | ▲ 22.8 จุด |
| MAE (โดยประมาณ) | 22.2 จุด | 9.5 จุด | ▲ 12.7 จุด |
| อยู่ภายใน ±10 จุด (ค่าคาดหวัง) | 17.5% | 58.1% | ▲ 40.6 จุด |
| สัดส่วนคำตอบที่ยุบไประดับเดียว | 47.9% | 25.9% | ▲ 22.0 จุด |
| ข้ามเซสชัน · ระดับ 41–60% ที่ถ่ายอีกวัน (ไม่เคยเห็นตอนเทรน) · n=79 | ก่อน (โมเดลปัจจุบัน) | หลังเทรนส่วนหัว | เปลี่ยน |
|---|---|---|---|
| ทายตรงระดับ (recall ของ 41–60%) | 38.0% | 39.2% | ▲ 1.3 จุด |
| คลาดเคลื่อนไม่เกิน 1 ระดับ | 89.9% | 93.7% | ▲ 3.8 จุด |
| MAE (โดยประมาณ) | 14.4 จุด | 13.4 จุด | ▲ 1.0 จุด |
เช็กทางลัด: โมเดลเรียน “ของในรถ” หรือแค่ “สีและเวลา”?
ตัวจำแนกง่าย ๆ ที่ดูเพียงค่าเดียว บนชุดทดสอบเดียวกัน — การชนะแถว “ดูสีอย่างเดียว” เป็นเงื่อนไขขั้นต่ำ ไม่ใช่ข้อพิสูจน์ว่าโมเดลมองของในรถ
| ตัวจำแนก | time-block · ทายตรง | time-block · MAE | ข้ามเซสชัน · ทายตรง |
|---|---|---|---|
| โมเดลปัจจุบัน (ก่อนเทรน) | 30.9% | 22.2 จุด | 38.0% |
| ดูสีอย่างเดียว (ความอิ่มตัวเฉลี่ย → ระดับใกล้สุด) | 27.8% | 19.3 จุด | 72.2% |
| ดูเวลาอย่างเดียว (ชั่วโมงที่ถ่าย → ระดับใกล้สุด) | 29.1% | 26.6 จุด | 0.0% |
| หลังเทรนส่วนหัว | 61.0% | 9.5 จุด | 39.2% |
เฉพาะระดับ 0% / 1–20% / 21–40% ซึ่งความอิ่มตัวสีแยกไม่ออก (n=192): หลังเทรน 68.8% เทียบดูสีอย่างเดียว 15.1% · การสุ่มแบ่งภาพแบบธรรมดา (รั่ว) ให้ 97.5% — จึงไม่ใช้ตัวเลขนั้น · สลับป้ายกำกับแบบสุ่มได้ 27.8% (ตรวจว่า pipeline ไม่จำอะไรผิด)
ชุดข้ามเซสชันมีระดับเดียว (41–60%) ซึ่งเป็นระดับที่โมเดลเดิมมักตอบอยู่แล้ว ตัวจำแนกใดที่ตอบ 41–60% แทบทุกภาพจะได้คะแนนสูงบนชุดนี้โดยอัตโนมัติ (“ดูสีอย่างเดียว” ได้ 72.2% ก็ด้วยเหตุนี้) ชุดนี้จึงใช้ยืนยันได้เพียงว่ายัง “ไม่เห็น” การเปลี่ยนแปลงในสภาพใหม่ ไม่ใช่ตัววัดความแม่นยำ
ช่วงที่คาดไว้ก่อนทดลอง (pre-registered)
- time-block · ทายตรงระดับ: 55–80%
- time-block · ±1 ระดับ: 85–97%
- time-block · MAE: 6–12 จุด
- ข้ามเซสชัน · recall: 30–70%
- ข้ามเซสชัน · MAE: 10–25 จุด
ข้อควรระวังในการอ่านตัวเลข
- ผลชุด time-block มาจากเซสชันเดียวกับที่ใช้เทรน (วันเดียวกัน แสงใกล้เคียง) ตัวเลขจึงสูงกว่าที่จะเจอกับรถคันใหม่หรือวันใหม่
- ผลข้ามเซสชันมาจากระดับ 41–60% เพียงระดับเดียว (n=79) ช่วงความเชื่อมั่นกว้างประมาณ ±11 จุด
- เทรนเฉพาะชั้นจำแนก (2,316 พารามิเตอร์) backbone ยังเป็นของโมเดลเดิม — เป็นการทดลองความเป็นไปได้ ไม่ใช่โมเดลส่งมอบ
- ป้ายกำกับเป็นช่วง 20% ค่า MAE และ ±10 จุด จึงเป็นค่าโดยประมาณจากจุดกึ่งกลางช่วง
- ภาพมีทางลัด (ความเหลืองของกล่อง นาฬิกาบนภาพ) — ตัวเลข 'ดูสีอย่างเดียว' และ 'ดูเวลาอย่างเดียว' แสดงไว้เพื่อเทียบ
- ระดับ 41–60% ที่ใช้ทดสอบข้ามเซสชัน เป็นระดับที่โมเดลเดิมมักตอบอยู่แล้ว (คำตอบยุบไปที่ระดับนี้) ค่า “ก่อน” ของชุดนี้จึงดูดีเกินจริง
- เฟรมที่อยู่ในช่องว่าง 5 นาทีระหว่างชุดฝึก/ตรวจสอบ/ทดสอบถูกตัดออก (ดูจำนวนในแถบสรุป) เพื่อกันเฟรมติดกันรั่วข้ามชุด
Confusion Matrix
ก่อนเทรน · ชุดทดสอบ time-block 382 ภาพ · ทายตรง 30.9%
Confusion Matrix
หลังเทรนส่วนหัว (seed ที่เลือก) · ชุดทดสอบเดียวกัน · ทายตรง 61.0% · วัดด้วย pipeline จริง
จากจุดเริ่มต้นสู่เป้าหมาย
From baseline to target
เป้าหมายเชิงเทคนิคของระยะที่ 2 คือ MAE ≤ 10 จุด และภาพอย่างน้อย 85% อยู่ภายใน ±10 จุด วัดบนชุดอ้างอิง 300 ภาพที่ผู้เชี่ยวชาญติดป้าย — เกจด้านล่างแสดงว่าวันนี้อยู่ตรงไหนเทียบกับเป้าหมาย
คลาดเคลื่อนเฉลี่ย (MAE โดยประมาณ) · ยิ่งน้อยยิ่งดี
วันนี้ 24.9 จุด · เป้าหมาย ≤ 10 จุด
สัดส่วนภาพที่อยู่ภายใน ±10 จุด (โดยประมาณ) · ยิ่งมากยิ่งดี
วันนี้ 19.7% · เป้าหมาย ≥ 85%
หมายเหตุ: ค่า MAE และสัดส่วน ±10 จุด เป็นค่าโดยประมาณ คำนวณจากจุดกึ่งกลางของช่วง เพราะป้ายกำกับปัจจุบันเป็นช่วงกว้าง 20% · MAE ใช้ระดับที่โมเดลตอบ (argmax) ส่วนสัดส่วน ±10 จุด ใช้ค่าคาดหวังถ่วงน้ำหนักด้วยความน่าจะเป็น (เช่น 41–60% ใช้ 50.5) ตัวเลขตามข้อกำหนดรับมอบจะวัดบนชุดอ้างอิง 300 ภาพ ที่ผู้เชี่ยวชาญ 3 คนติดป้ายเป็นเปอร์เซ็นต์จริง
ระยะห่างนี้คาดว่าปิดได้ด้วยการเทรนโมเดลใหม่ด้วยภาพรถ EV ร่วมกับการเก็บภาพให้หลากหลายขึ้น — รายละเอียดอยู่ในแผนพัฒนา
ดูแผนพัฒนาโมเดล →วิธีวัด: รันโมเดล dinov3 (offline, CPU) บนภาพ 1,811 ภาพ · เวลาเฉลี่ย 132.9 ms/ภาพ · สร้างเมื่อ 2026-09-02T18:45:20 · ชุดข้อมูล ev-phase2